

グローバル組織に選ばれる圧倒的なAI翻訳品質
言語の専門家やアナリストから世界20万社以上の組織まで、多くの支持を集めるDeepL。テキスト、音声、ドキュメントのすべてにおいて、圧倒的な高精度翻訳を実現します。
DeepLは比較評価の89%で勝利
テキスト翻訳の品質品質スコア 96.4
音声翻訳の品質 — Microsoft Teams、Google Meet、Zoomの評価スコアは87~89(2026年Slatorレポート)100以上の言語
ドキュメント翻訳品質 — 主要なあらゆるファイル形式に対応し、100以上の言語へレイアウトを維持したまま正確に翻訳信頼の翻訳品質
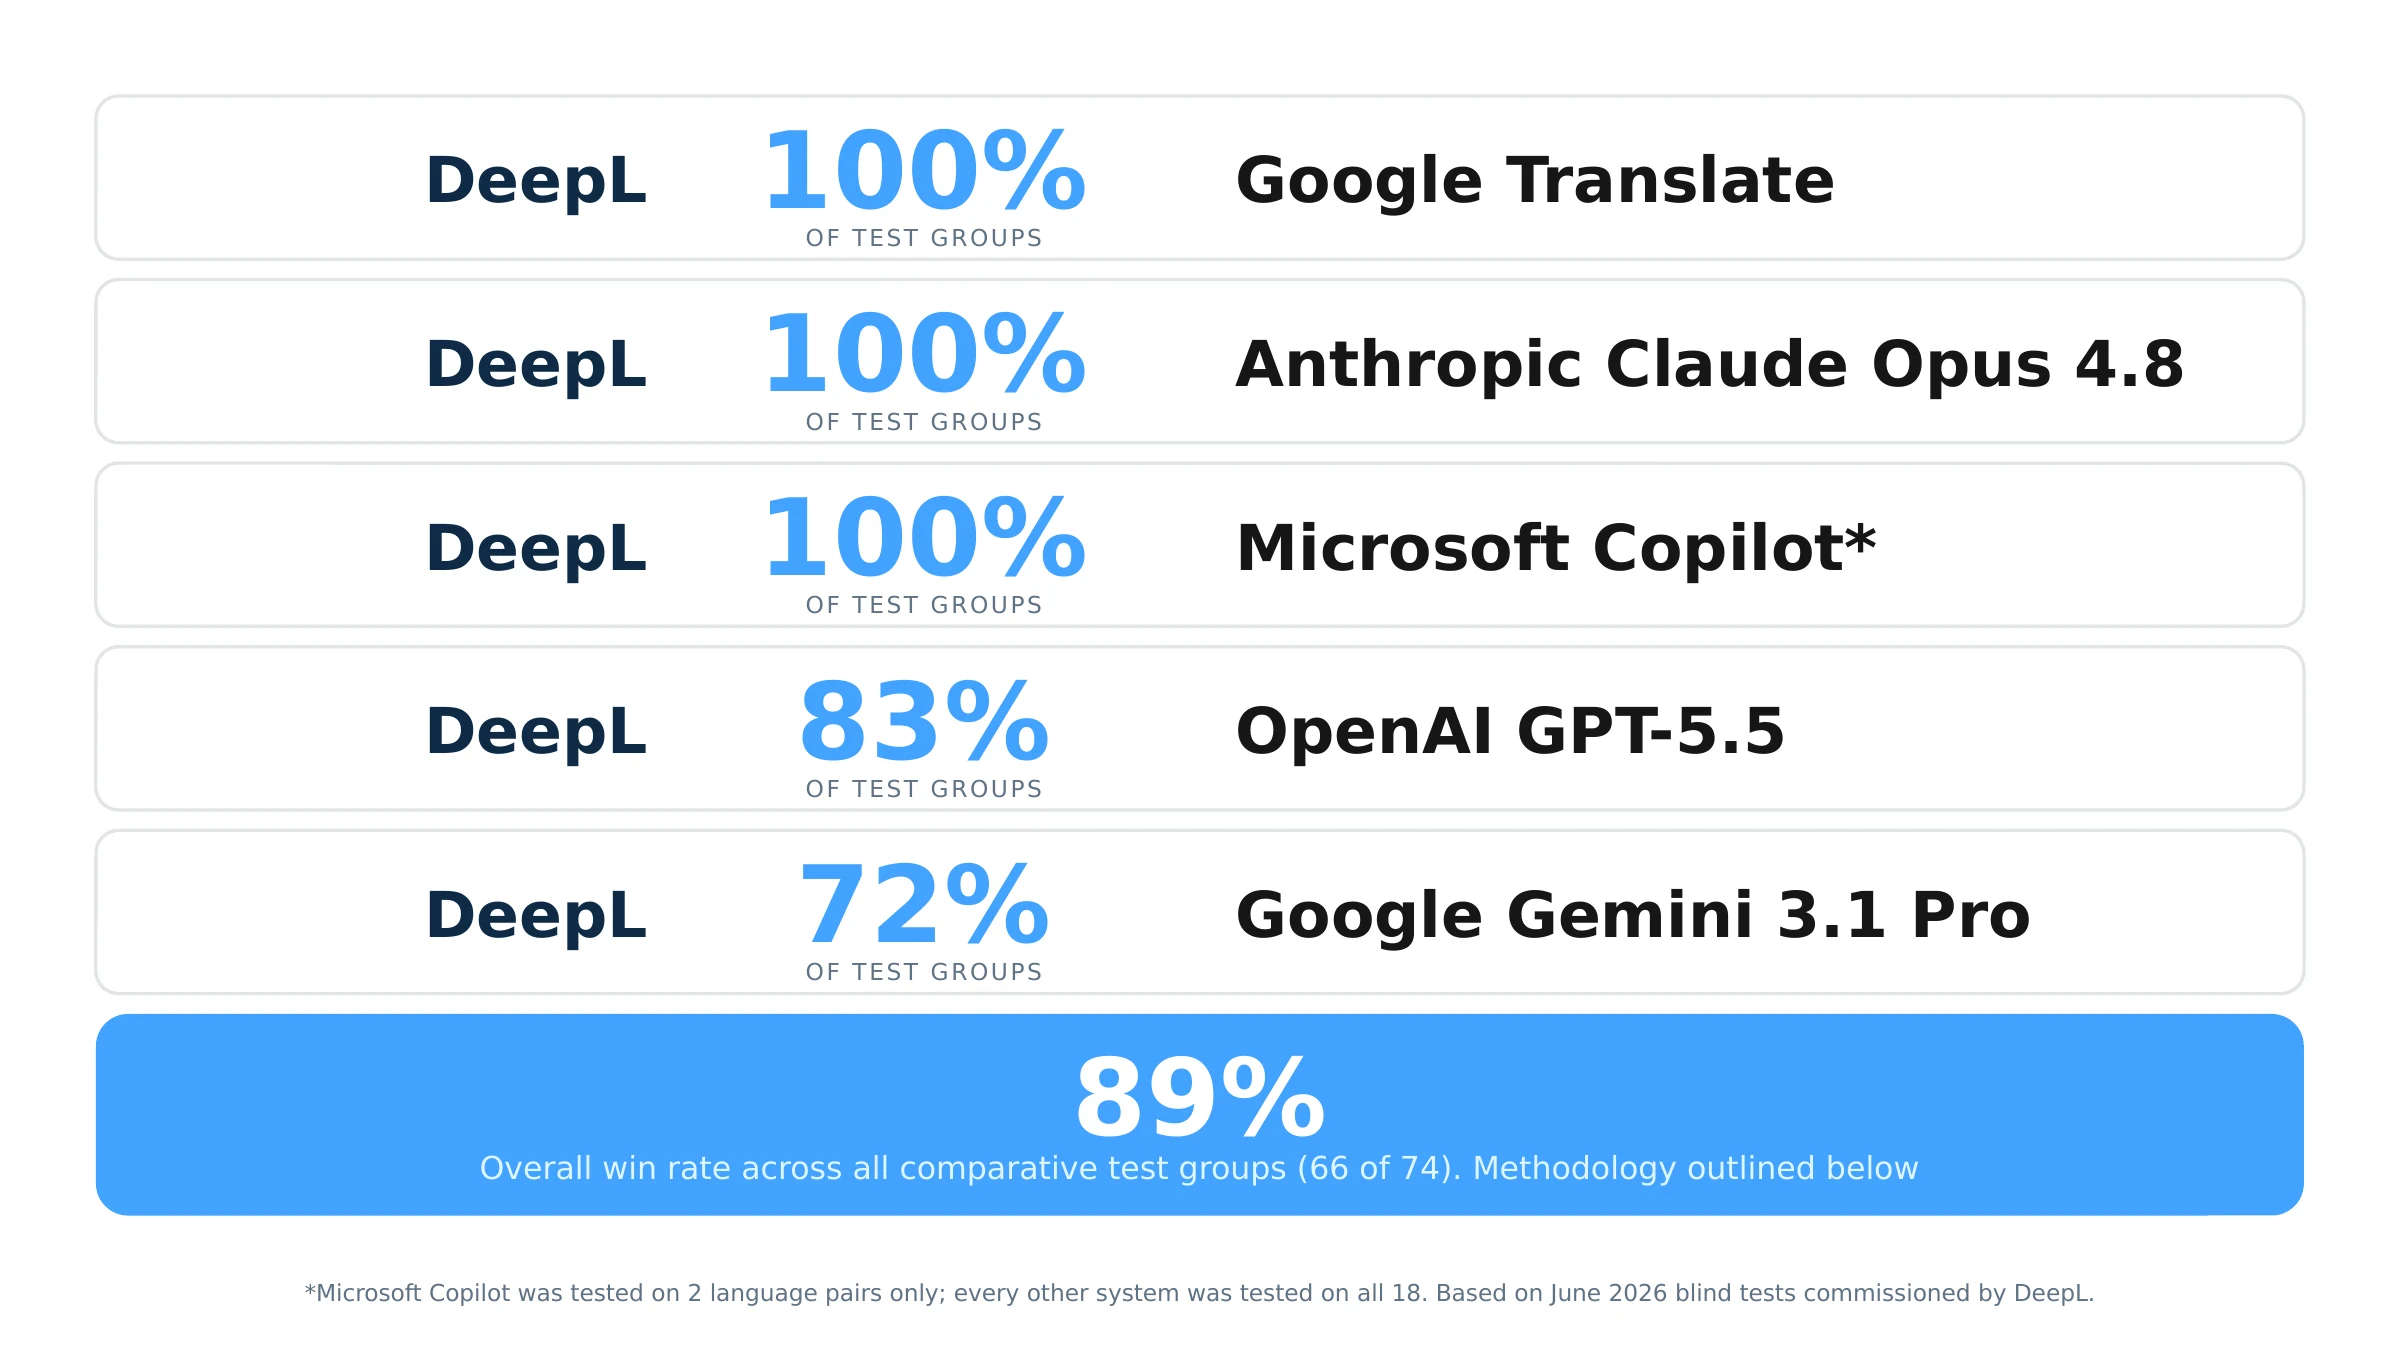
DeepLは、18の言語ペアおよび7社の競合他社と比較したブラインドテストにおいて、全対戦グループの89%(74回中66回)で勝率を記録しました。*
業界をリードする音声翻訳
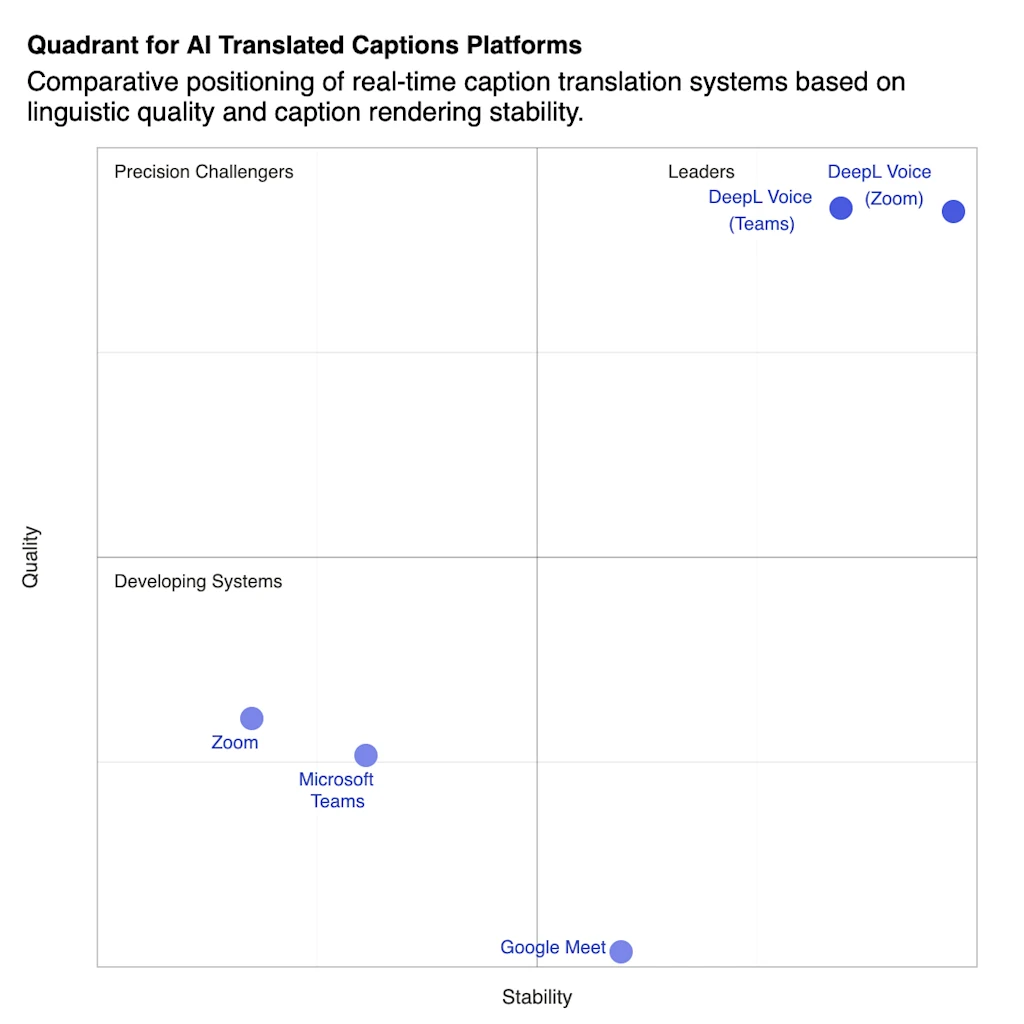
2026年3月に実施されたSlatorによるAI翻訳字幕の市場評価において、言語専門家の96%がDeepL Voiceを第1位にランク付けしました。
- 他社評価プラットフォームと比較して、重大あるいは主要な翻訳エラーが76%減少
- Microsoft Teamsと比較して、セグメントあたりのエラーが66%減少。Zoomと比較して64%減少
- Zoomでの品質スコアは96.4、Teamsでは96.3、その他のプラットフォームでは87~89
最高水準の字幕:競合他社と比較して88.6および85.8の安定性スコア
貴社ブランドのために構築された、唯一のAI翻訳ソリューション
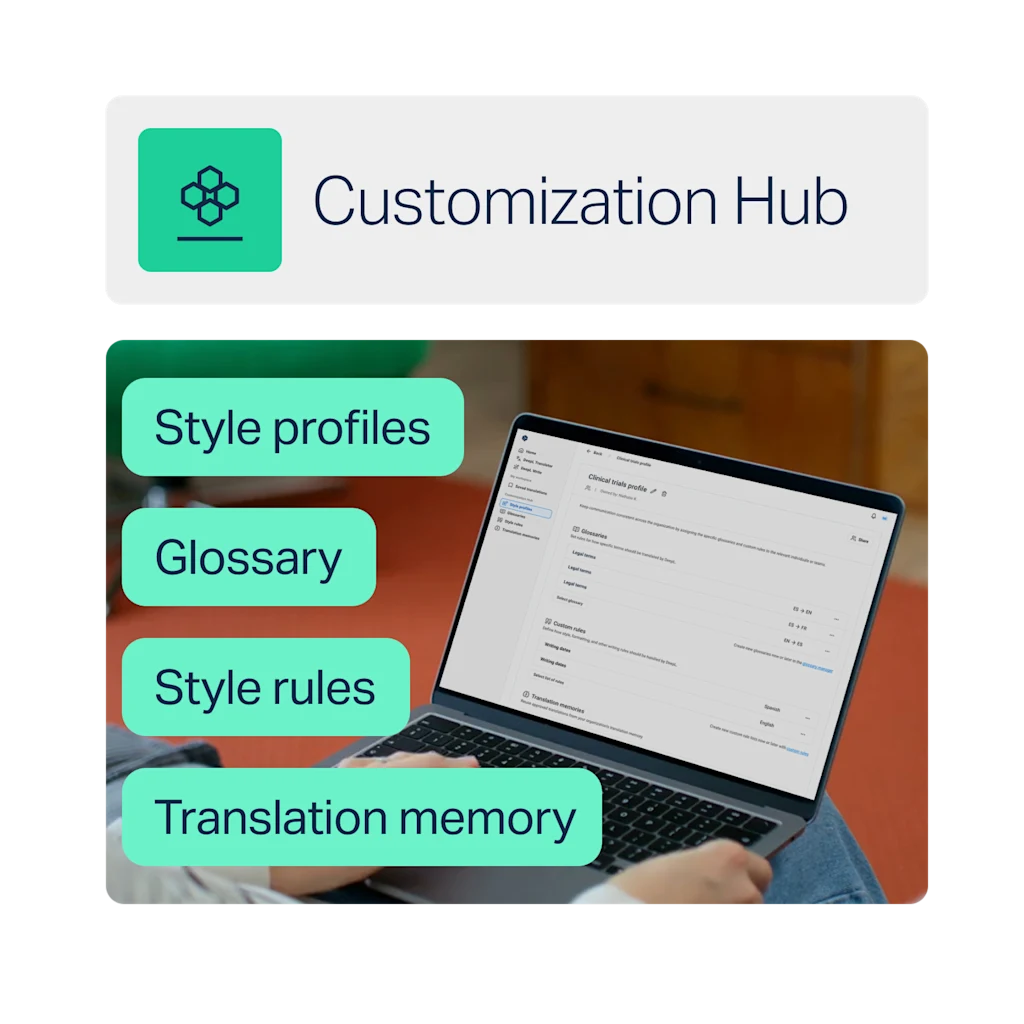
翻訳品質とは、単なる言語の置き換えにとどまりません。貴社の用語、語調、そして独自のスタイルの反映が求められます。DeepL Customization hubは、チームが用語集、スタイルルール、翻訳メモリ、スタイルプロファイルを通じて、ブランドボイスやトーン&マナーを大規模に定義・管理できる、企業向けのプラットフォームです。
DeepLなら、AI特有の没個性的な翻訳に陥ることはありません。常に正確で一貫性を保ち、貴社のブランドアイデンティティを体現する翻訳を実現します。
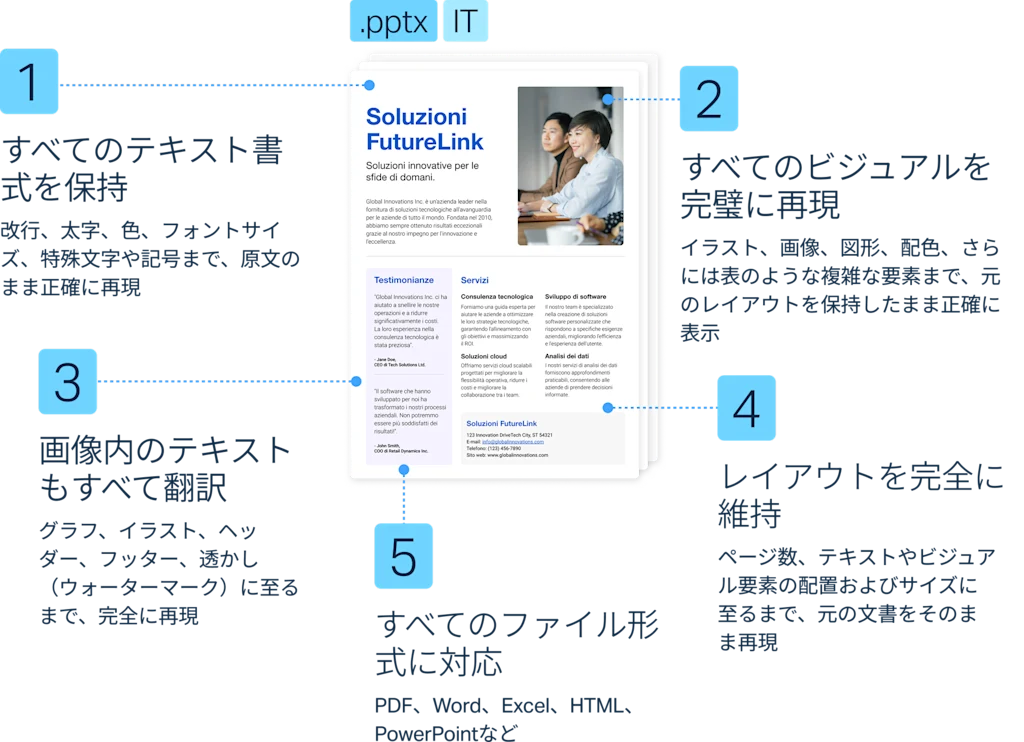
デザインの細部まで忠実に再現する、大規模ファイル翻訳
DeepLのドキュメント翻訳は、元のデザインのレイアウトや書式、視覚的なコンテキストを維持したまま、PDFをはじめとする30種類以上のファイル形式を100以上の言語へ瞬時に変換。時間と手間を最小限に抑え、コスト削減に大きく貢献します。
最高のAI翻訳が最高のビジネス成果を生み出す秘密
DeepLの翻訳品質がビジネスを支える10の理由
- 345%の投資収益率(ROI):Forrester社のTEI調査に基づく3年間の投資利益率
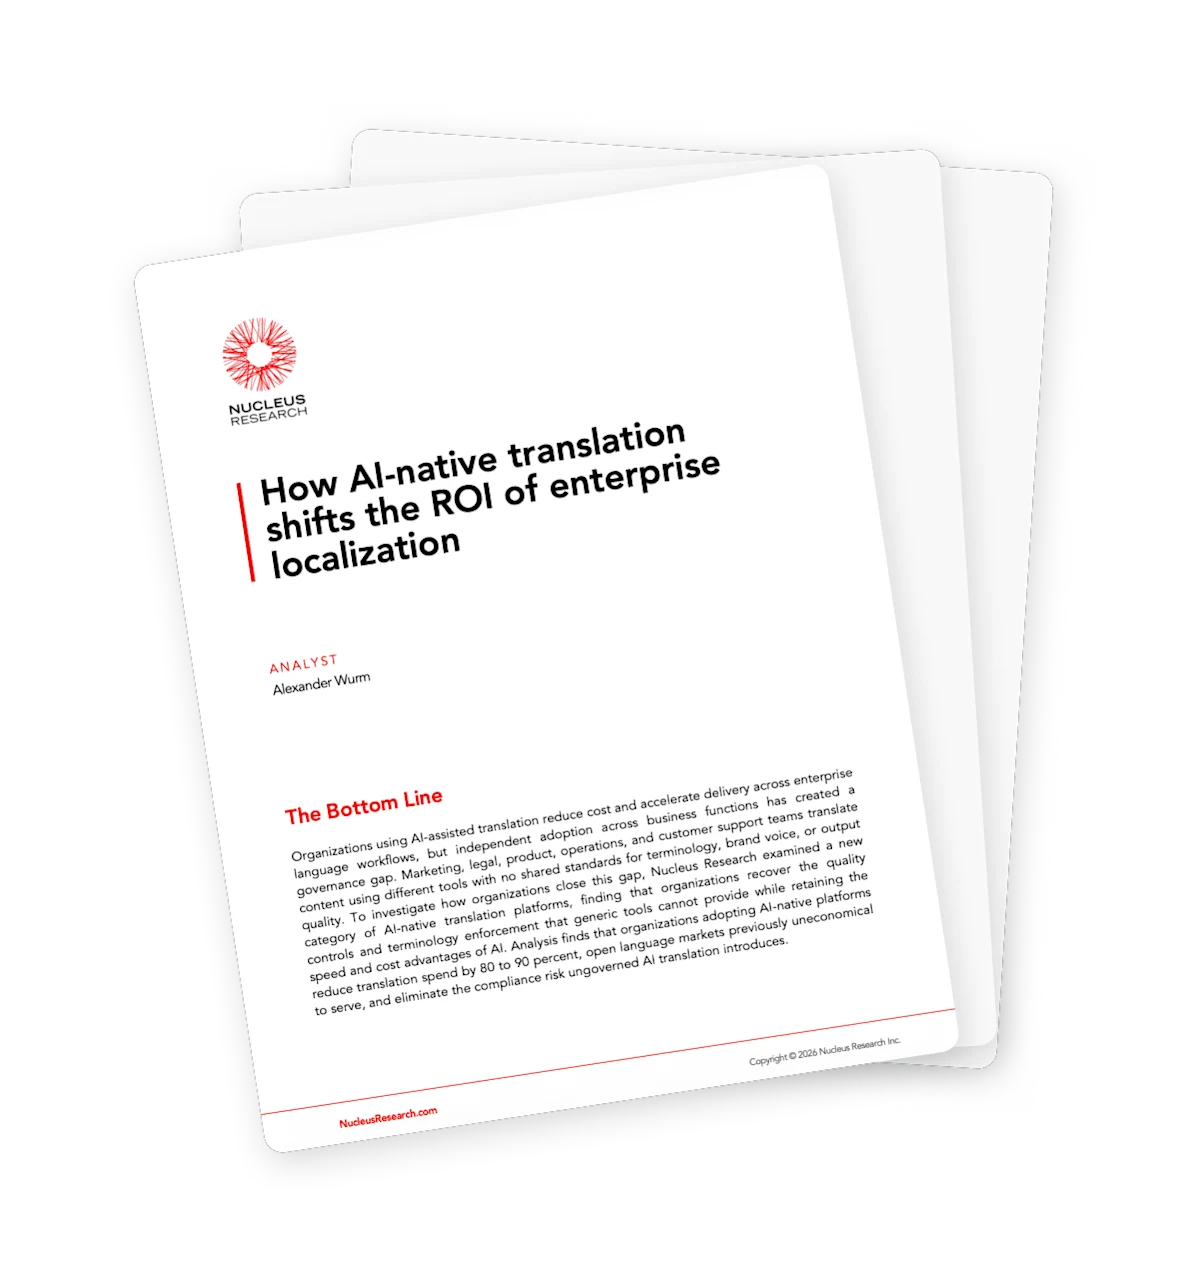
- 80~90%のコスト削減:AIネイティブなプラットフォームを導入した組織は、翻訳コストを80~90%削減(Nucleus Research社調べ)
- LSPおよび外部サービスのコストを削減:グローバルなコンテンツ運営において、遅延と外部委託コストを削減
- 市場参入の迅速化:ボトルネックを解消し、顧客の母国語でサービスを提供することで新たな市場を開拓
- 翻訳サイクルが90%短縮: 翻訳にかかる時間を数日から数時間に削減
- リスクと法令遵守の負担を軽減:SOC 2 Type 2、ISO 27001、GDPRに準拠し、顧客データによるAI学習は一切なし
- ブランド一貫性の向上:すべての言語と市場において、用語、語調、ボイスを統一
- 翻訳作業量を50%削減:翻訳者やコンテンツチームを反復的なポストエディット作業から解放
- 売上の向上:消費者の76%が母国語で製品情報が提供されていることを購入の判断基準として重視
- 言語を競争優位性の源泉に:AIネイティブな翻訳で、ローカライズを外部委託コストから拡張可能な収益源へ転換
翻訳には、単なる予算以上のコストがかかっています。
規模が拡大するにつれて膨らみ続ける外部委託費。機密性の高い重要コンテンツを任せるには心許ない汎用AI。そして、その両方の管理に追われるチームの貴重な時間。
独立系グローバル技術リサーチ企業であるNucleus Researchは、これらの影響を数値化し、より優れたモデルの優位性を実証しました。
DeepLの翻訳品質を支える技術
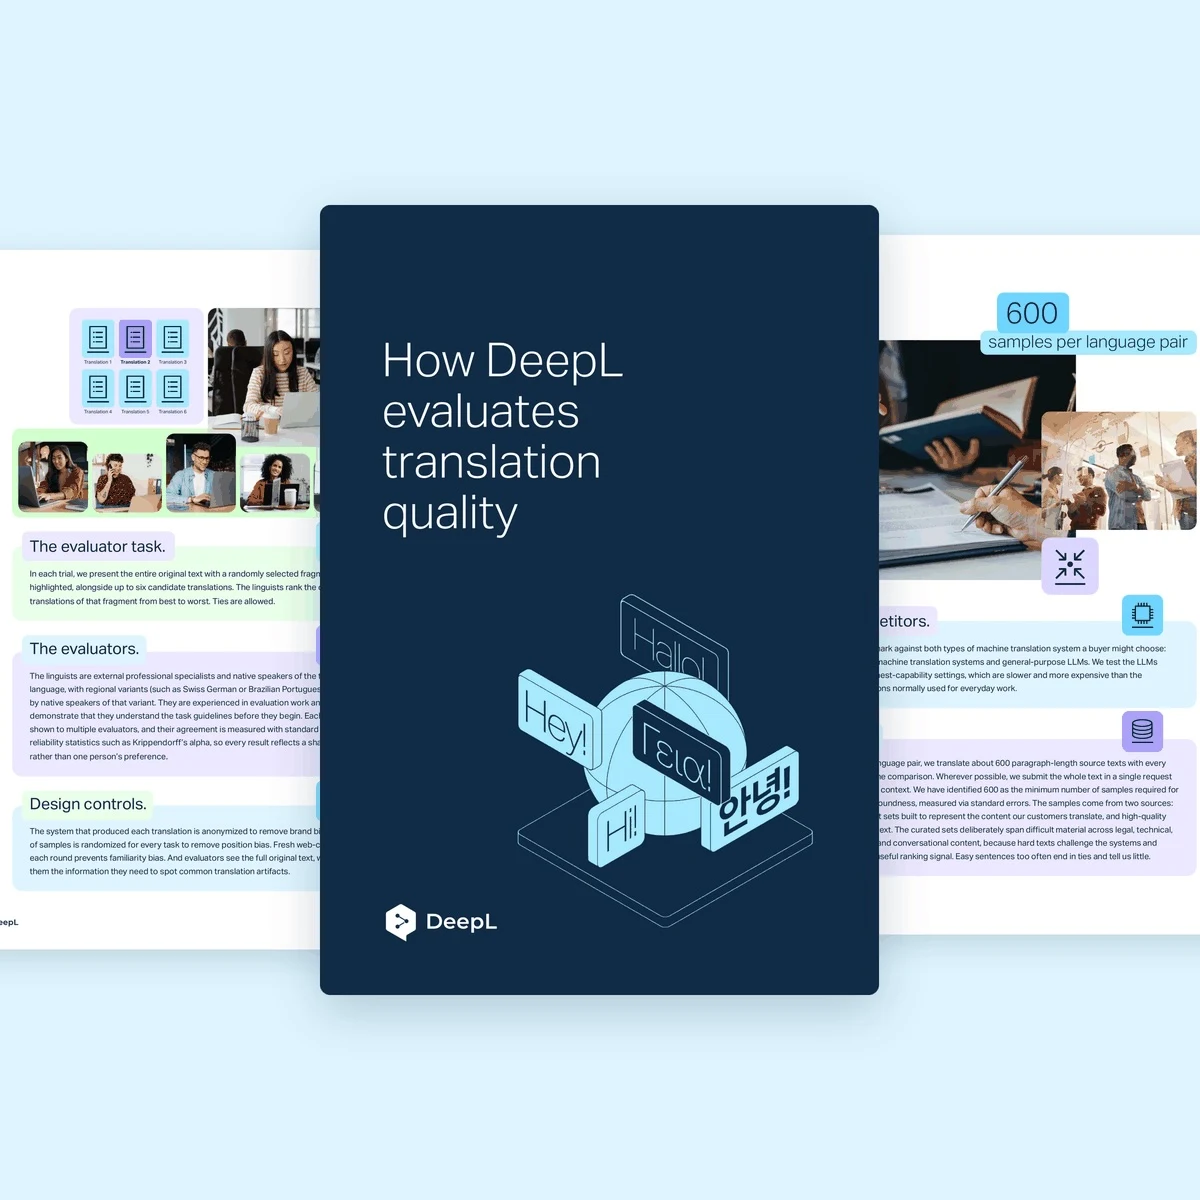
テキストの翻訳品質は評価が難しく、評価結果が恣意的に操作されやすいものです。このホワイトペーパーでは、DeepLがブラインド方式による人間の比較評価を用いて翻訳品質を評価する方法、BLEUやCOMETといった既存の評価指標の限界、そしてDeepLのベンチマーク手法が実際に何を検証しているのかについて解説します。
20万以上の組織が、DeepL翻訳の翻訳品質を信頼する理由
お客様の声
「DeepL Voice for Meetingsは、世界中に点在する社員たちの心の距離を確実に近づけてくれました」
「DeepLは弊社の翻訳業務を大きく変えました。顧客にコスト削減効果をもたらしただけでなく、弊社のプロジェクト効率化も実現できました」
「機械翻訳の品質は、依然として市場でも最高水準にあります」
「以前はとても非効率で、60分の会議のうち、おそらく30分は余計にかかっていました。DeepL Voiceを導入した今では、誰もが会話にしっかり参加できています」
「遅延の少なさ、導入の容易さ、コスト…これらすべてが重要な要素であることは間違いありません。しかし、パズルのピースとして何よりも重要なのは、やはり『品質』です」
「ツールの精度比較も行っています。数値で測るのは簡単ではありませんが、社内では『DeepLは精度が非常に高く、使いやすい』という声が頻繁に上がっています」
最高のAI翻訳ソリューションについて
DeepLは、独立したブラインドテストにおいて、プロの言語学者から最も高い評価を得ているAI翻訳ソリューションです。2026年6月に行われたブラインドテストにおいて、DeepLはOpenAI GPT-5.5、Gemini 3.1 Pro、Claude Opus 4.8、Google翻訳、Microsoft Copilotとの比較評価で89%の勝率を記録しました。
はい。ブラインドテストにおいて、DeepLは高度な推論機能を有効にしたOpenAI GPT-5.5との比較評価で、テスト対象となった18の言語ペアのうち15(83%)で勝利を収めました。
2026年6月のブラインドテストでは、DeepLはテスト対象となった18の言語ペアすべて(100%)で勝利を収めました。
DeepLは、音声翻訳において30以上の言語に対応しており、テキストおよび文書ファイルの翻訳では100以上の言語に対応しています。
はい。DeepLは、SOC 2 Type 2認証、ISO 27001認証を取得しており、GDPRに準拠しています。DeepLは、お客様のデータを保持したり、お客様のコンテンツを用いてモデルを訓練したりすることはありません。