

DeepL 번역 품질의 과학적 원리
번역 품질은 측정하기 어렵고 조작하기 쉽습니다. 이 백서는 DeepL이 블라인드 비교 인간 평가를 사용하여 품질을 평가하는 방법, BLEU 및 COMET과 같은 기존 지표가 부족한 이유, 그리고 당사의 벤치마킹 방법론이 실제로 무엇을 테스트하는지 설명합니다.
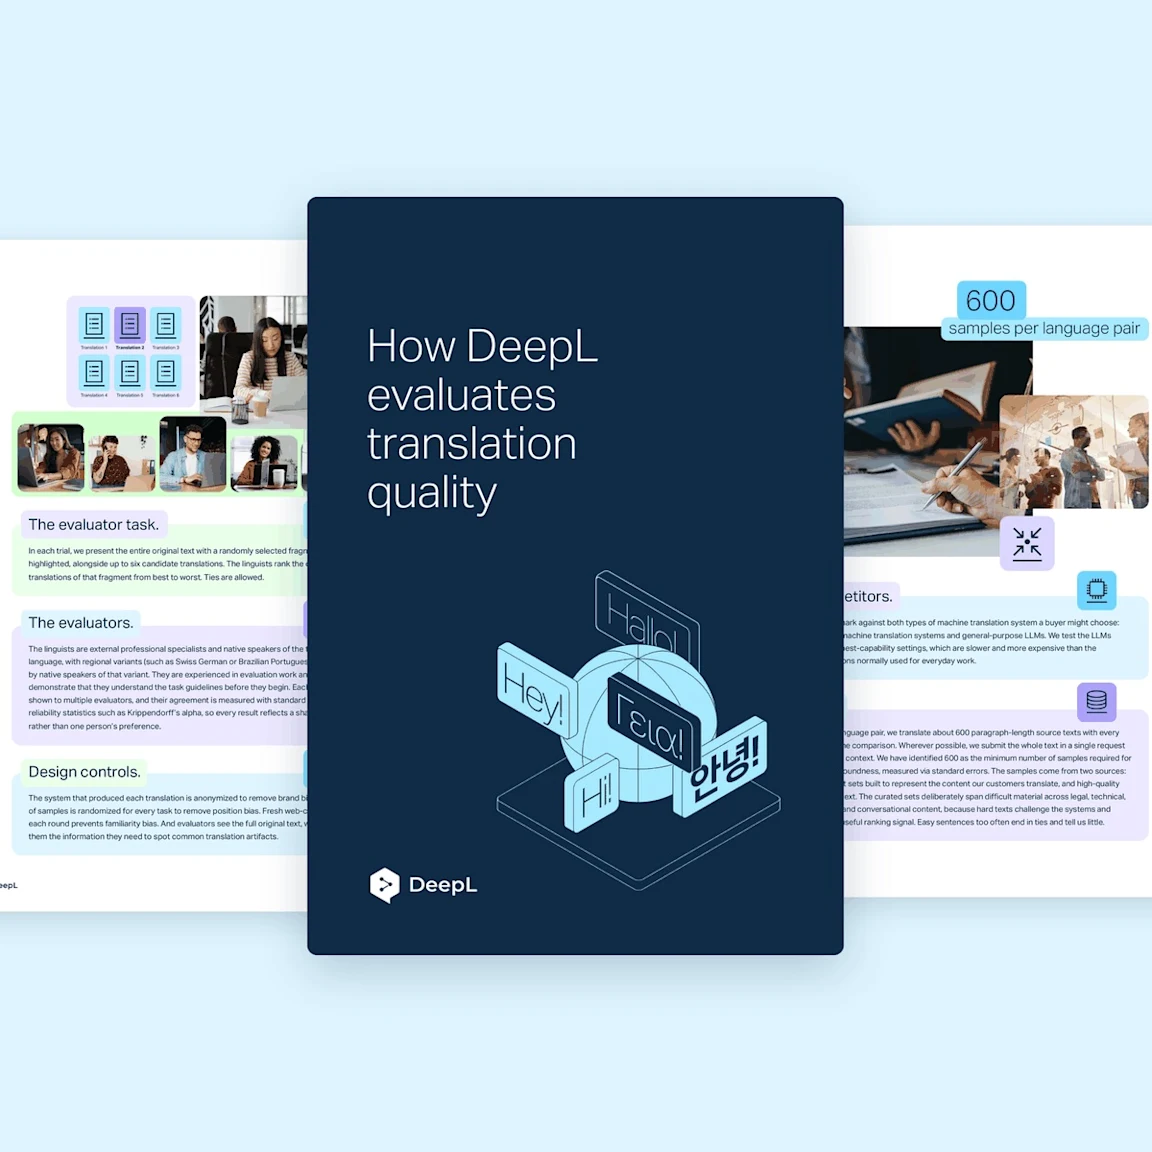
백서에는 어떤 내용이 담겨 있나요?
- BLEU와 COMET의 한계— 유창성 중심 점수가 실제 운영에서 가장 중요한 오류를 놓치는 이유
- DeepL의 블라인드 비교 평가 방법론— DeepL이 브랜드, 포지션, 친숙도 편향을 제거하기 위해 테스트를 설계하는 방법
- 승률 계산 방법— 쌍별 비교 모델로 품질 순위를 생성합니다
- 접근 방식의 솔직한 한계— 벤치마크가 알려주는 것과 알려주지 않는 것
백서 다운로드
복사본을 받으세요## DeepL가 번역 품질을 평가하는 방법방법론에 대해 더 알아보려면.